AIの小さな判断を自動化するには?CodexとJevの違いを具体例で解説
NEW10月1日公開※内容は運営者が考え、AIで整えています。
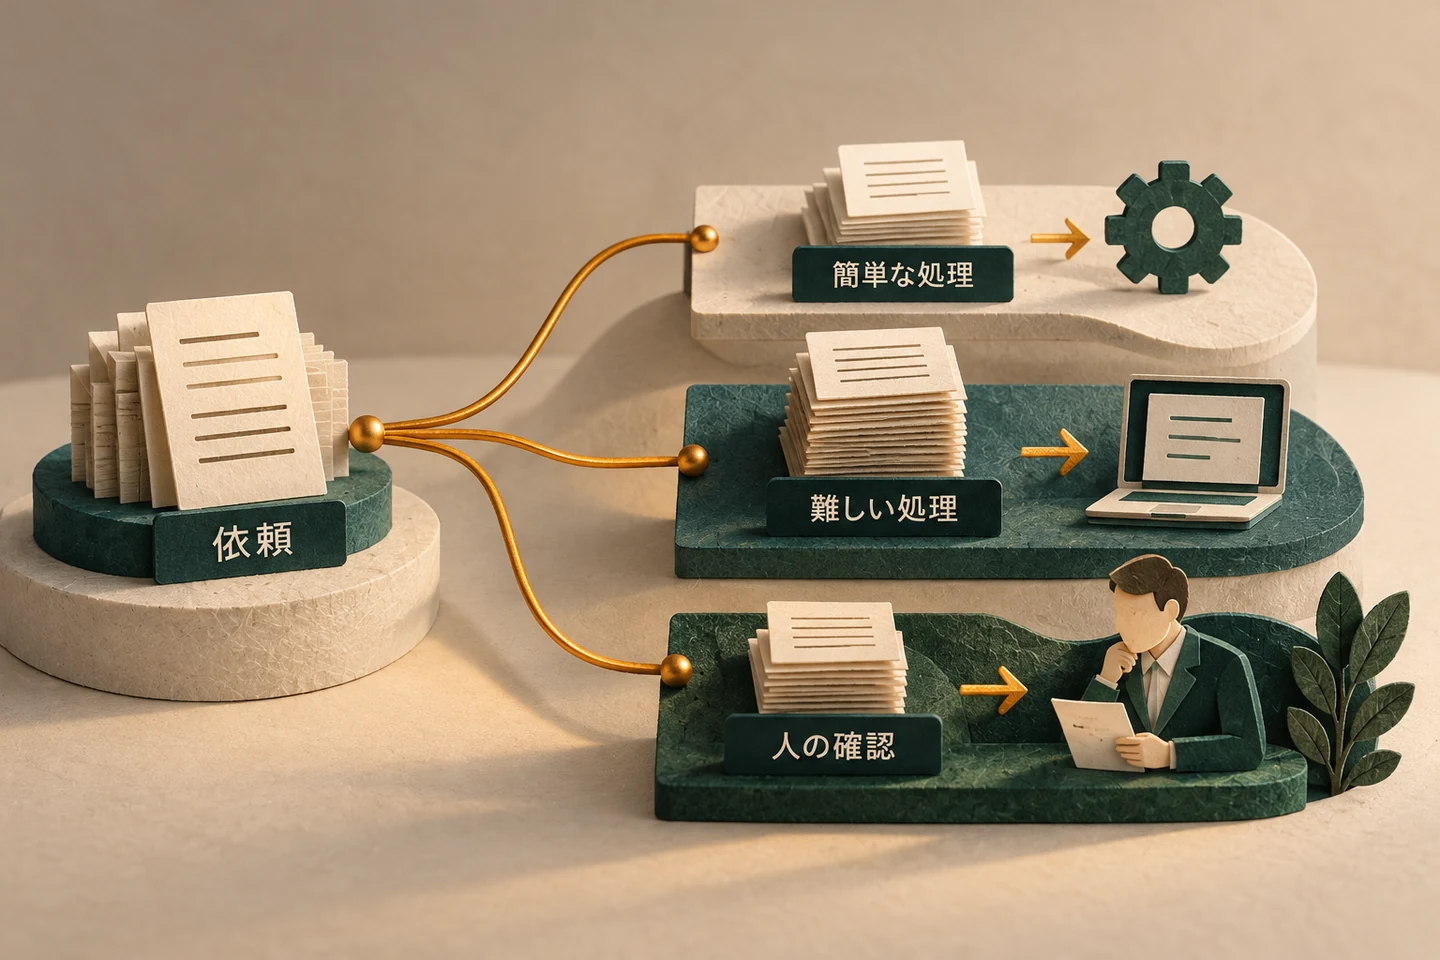
問い合わせを読む。返信が必要か考える。講座の相談か、営業時間の質問かを分ける。AIが書いた告知を見て、日時や申込先がそろっているか確かめる。
一つずつは短い作業でも、何度も続くと時間を取られます。こうした「小さな判断」を先にAIへ任せ、難しい仕事だけに大きな力を使う。それが、この記事で紹介する考え方です。
きっかけは「CodexにDecision Modelが搭載され、Jevが不要になるかもしれない」という話。ただ、公式資料を調べると、ここは分けて理解する必要がありました。
2026年10月1日の調査では、Codexの汎用機能として「Decision Model」という名前の判断専用モデルを自由に呼び出せる、という公式仕様は確認できませんでした。 確認できたのは、操作を審査するAuto-reviewと、APIを使って判断・振り分けを組む方法です。
「判断役を置くと便利」という方向性には意味があります。名前の混同をほどき、何が実際にできるのかを、身近な仕事から見ていきましょう。
Codexの操作審査と、仕事を仕分ける判断役は役割が違う
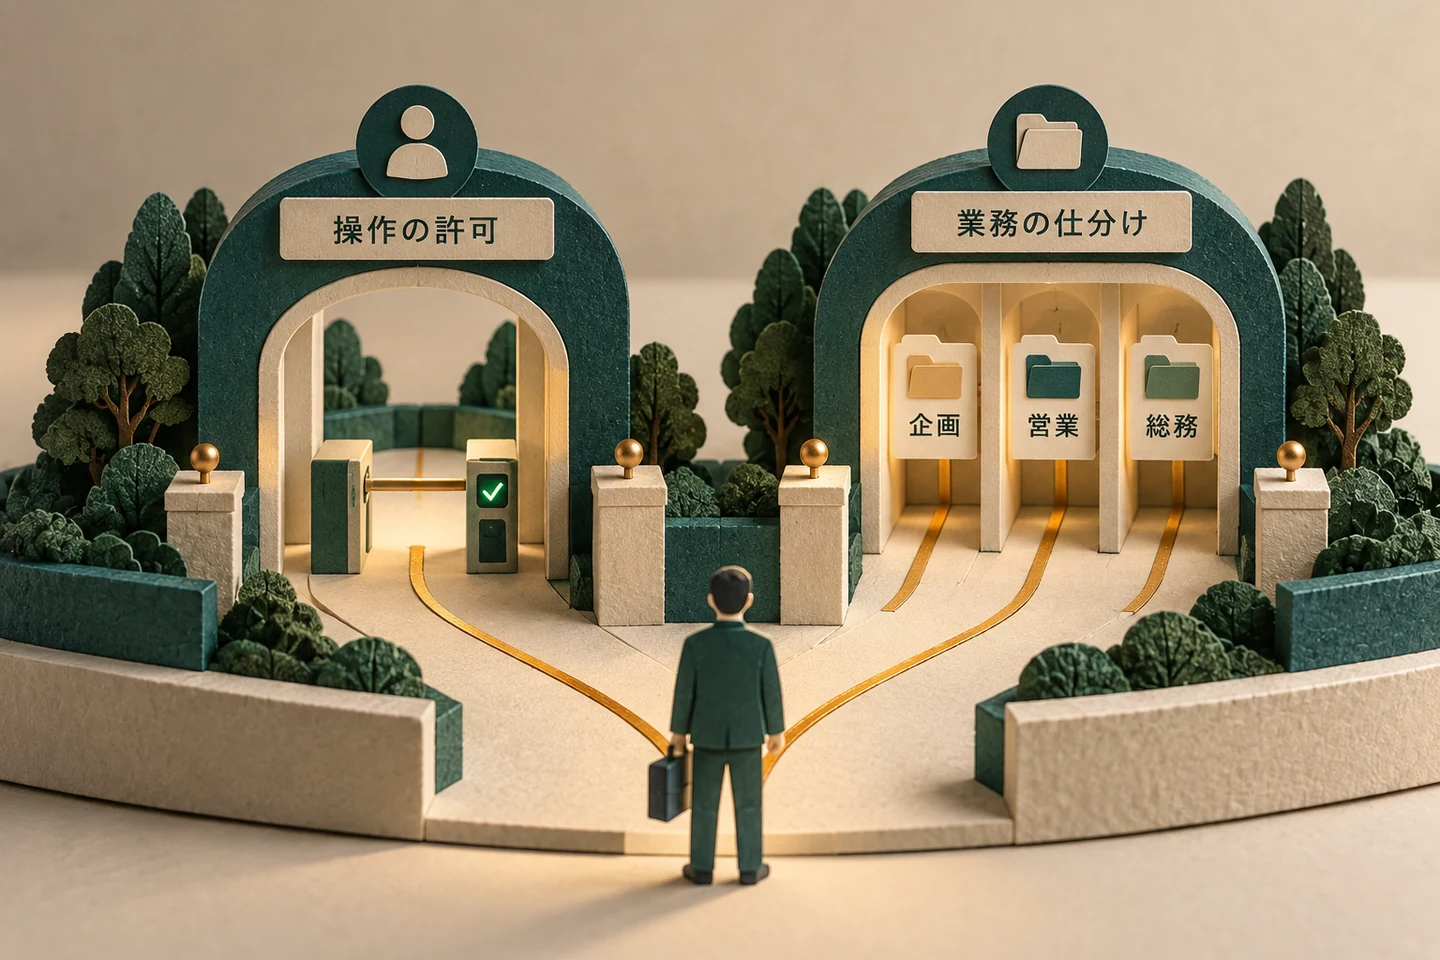
まず、言葉を三つに分けると分かりやすくなります。
| 仕組み | 主な仕事 | 例 |
|---|---|---|
| CodexのAuto-review | 実行許可が必要な操作を審査する | 作業範囲を越えるファイル操作を許可してよいか |
| LLMで作る判断役 | 文章を読み、決めた形式で分類結果を返す | 問い合わせを「講座・営業時間・その他」に分ける |
| Jev | 状態と質問を受け、型の決まった判断結果を返す | 候補の選択、基準に沿った採点、命題の確からしさ |
CodexのAuto-reviewは、必要な承認を別の審査役へ渡す機能です。通常の許可範囲で動くすべての処理を毎回採点する機能ではありません。権限そのものを広げるものでもありません。OpenAI公式:Auto-review
一方、問い合わせを仕分ける判断役は、アプリの中に自分で組むものです。OpenAIのStructured Outputsを使うと、たとえば回答の項目や選択肢を定め、プログラムが扱える形式で結果を受け取れます。ただし、形式が合っていても、分類の中身を間違えることはあります。 OpenAI公式:Structured Outputs
JevはTypeSafe AIの判断モデルです。公式資料では、候補から選ぶChoice、基準で採点するScore、ある命題が正しい確率を返すNoulを説明しています。ChoiceとScoreには確率分布とconfidenceもあります。TypeSafe公式:Introduction
つまり、Codexに振り分けの仕組みを作ってもらうことと、Codex自身に専用の判断APIが標準搭載されていることは、同じではありません。 「最初に判定して振り分けて」と頼めば、実装の相談やコード作成はできます。その先には、利用できるモデル、呼出方法、結果の検証、振り分け先の接続が必要です。
問い合わせ・記事チェック・難しい依頼を先に仕分ける
以下は、地域の事業者や講師が仕組みを考えるための仮想例です。実際の導入実績や削減効果を示すものではありません。
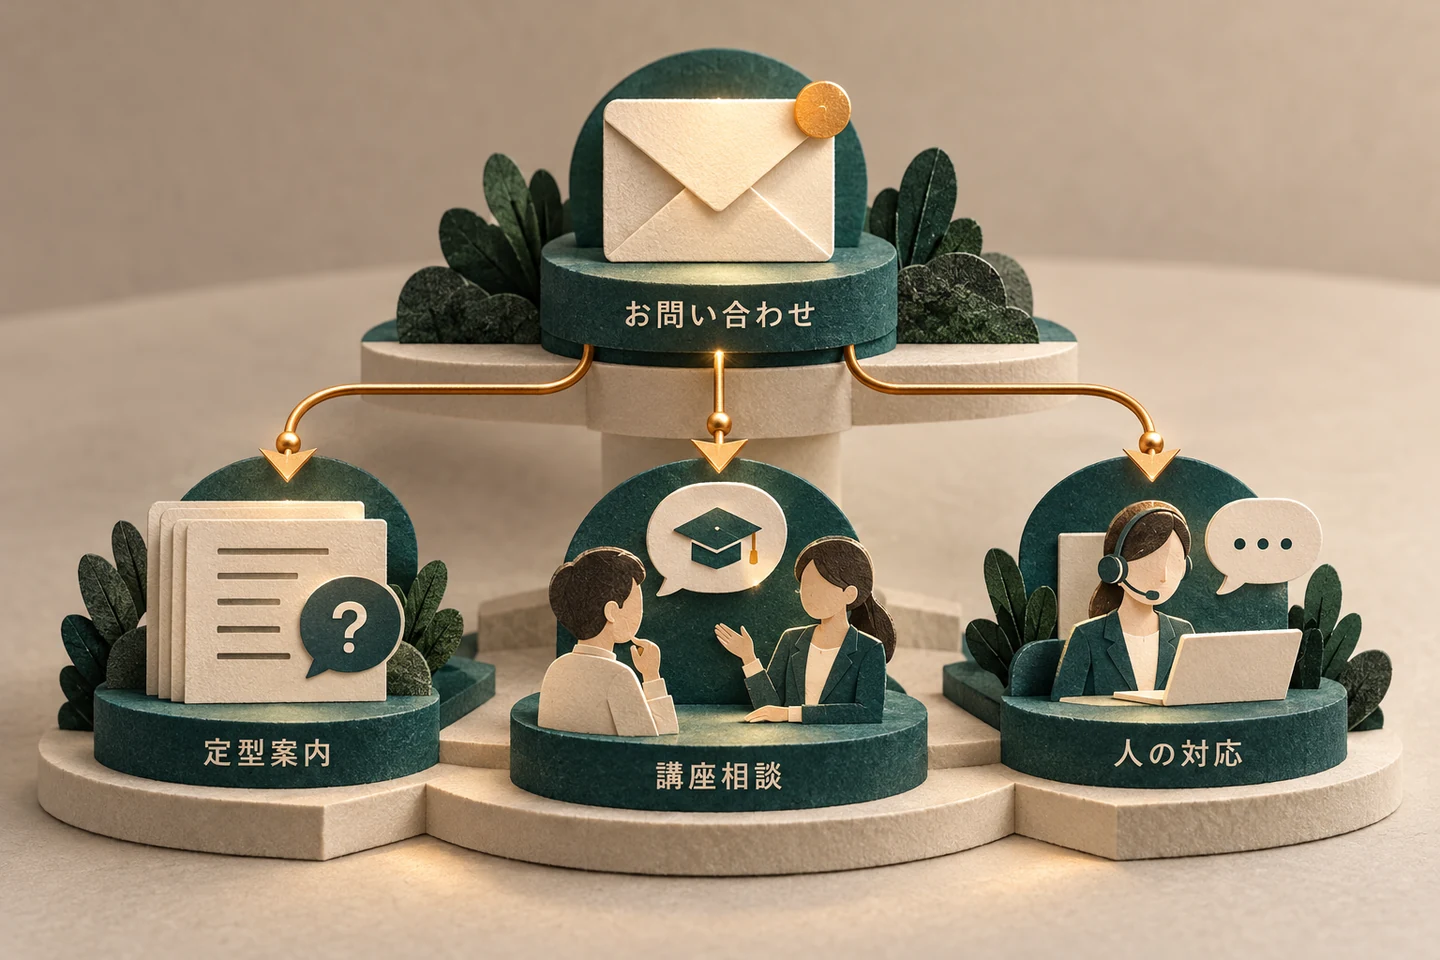
例1:講座の問い合わせを、読む前に分ける
「初心者でも参加できますか?」なら、確認済みの講座案内から返信案を作る。「学校で研修を頼めますか?」なら、人数・目的・日程を聞く相談窓口へ。「返金してほしい」なら、人の確認へ渡す。
ここで判断役に、いきなり「良い返事を書いて送って」と任せません。まず「定型案内」「個別相談」「人の確認」の三つから選ばせます。
問い合わせ → 仕分け → 担当が返信案を作る → 必要な確認 → 送信
選択肢には「情報不足」も設けます。文章に「初心者」とあっても、「初心者向けと聞いたが内容が違った」という苦情なら、定型案内へ回すのは不適切だからです。
営業時間が確定データから取得できるなら、回答内容は通常のコードで取り出せます。AIに毎回営業時間を推測させる必要はありません。
例2:記事を「整える前」に点検する
イベント告知なら、日時・会場・料金・申込先があるかを確認します。URLが空欄か、日付の形式が正しいかなど、機械的に判定できることはコードへ。
「初めての人にも伝わるか」「根拠のない効果を言い切っていないか」のように文章の意味を読む判断だけ、AIへ渡します。足りない箇所を見つけたら修正役へ、出典が足りなければ調査役へ回します。
AIが『公開してよい』と答えたことだけで、事実確認や公開承認が済んだことにはしません。 判定・修正・公開を分けることで、どこで間違えたかも追いやすくなります。
例3:簡単な依頼は軽く、複雑な依頼は深く考える
「この案内を短くして」は軽い処理。「申込の離脱が多い。ページと予約導線を調べて改善して」は調査と推論が必要です。「この文章を法的に問題ないと言い切って」は、人や専門家の確認を含む扱いになります。
判断役は、単に文章の長さで決めません。資料の不足、必要なツール、間違えたときの影響を見ます。利用できる処理先だけを選択肢にし、接続できない高性能AIへ送ったつもりになることも防ぎます。
OpenAIの公式資料も、専門役への引継ぎと、コードによる実行順序の制御を説明しています。振り分けは、選ぶAIと、実際に呼び出すコードがそろって初めて動きます。 OpenAI公式:Orchestration and handoffs
Jevを省けるかは、速度・誤判定・運用負担を比べて決める
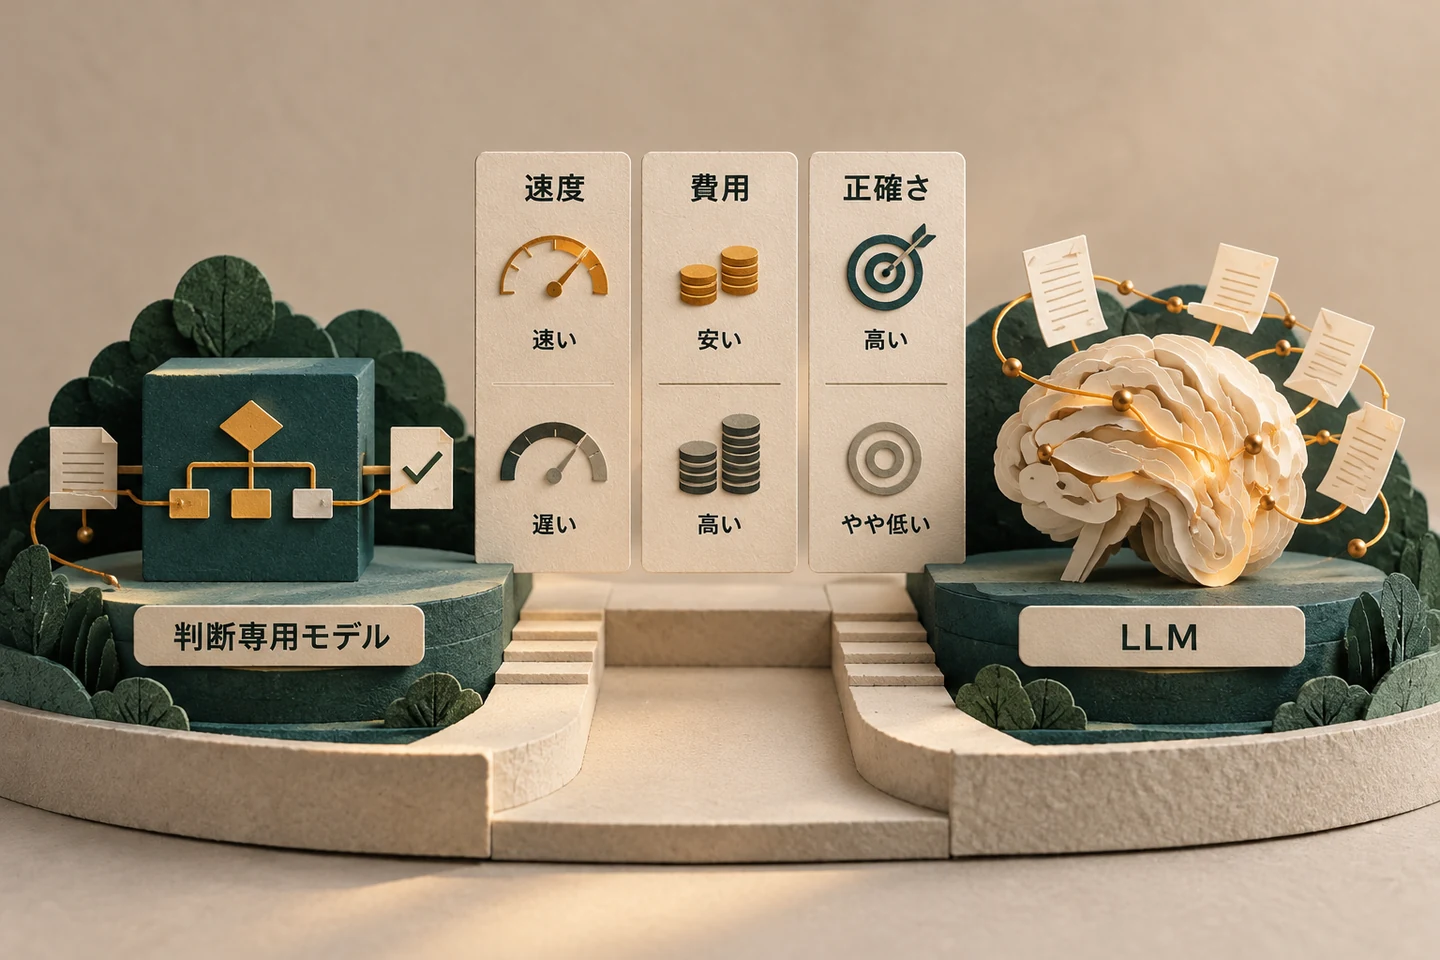
JevとLLMの判断役は、どちらも分類や評価に使えます。そのため、用途によってはJevを追加せず、既存のLLMだけで十分な場合があります。 これは設計上の可能性であり、今回の実測結果ではありません。
| 仕事の条件 | 最初に試す候補 | 比べること |
|---|---|---|
| 日付・空欄・決まった値を確認する | 通常のコード | ルールで確実に判定できるか |
| 少量の文章分類で、既存LLMが使える | LLMのStructured Outputs | 誤分類と接続・保守の手間 |
| 短い判断を大量に、素早く繰り返す | Jevと軽量LLMの比較 | 実環境の応答時間、料金、品質 |
| 長い資料を読み、理由や改善案も必要 | 推論・生成が得意なLLM | 根拠の整合性と完成までの時間 |
| 誤りの影響が大きい | 人の確認を含む構成 | 見逃し、権限、責任の所在 |
TypeSafeは2026年9月15日の発表で、Jevの応答速度を70〜500ms、入力100万トークン当たり0.042ドル、出力無料と説明しています。発表時点の提供元公表値で、こちらの測定値でも、現在の契約料金の保証でもありません。 通信距離や入力、再判定、後段の処理によって全体の費用と時間は変わります。TypeSafe公式発表
また、LLMに「自信を0〜1で返して」と頼んだ数字を、そのまま正答率だと思わないことも大切です。Jevのconfidenceも、ChoiceやScoreの確率分布から計算した指標です。0.9と返った一件が、90%の正しさを保証されるわけではありません。 実際の仕事で、どの値から任せられるかを調べます。TypeSafe公式:Confidence
費用は次のように考えます。
全体の費用 = 判断役の費用 + 振り分け先の費用 + 再試行・人の確認の費用
たとえば、1件の重い処理を10円、仕分けを0.2円、軽い処理を1円と仮定します。100件のうち80件を軽く、20件を重く処理できれば、全件を重く処理する1,000円に対し、仕分け20円+軽い処理80円+重い処理200円=300円です。
これは仕組みを説明する架空の計算で、実サービスの価格や70%削減の実績ではありません。 失敗のやり直しや人の確認は別です。全部が難しい依頼なら、仕分け分だけ余計にかかる場合もあります。
Jevが不要かどうかは、「同じ判定項目があるか」より、「同じ品質で、仕事全体が速く安く回るか」で決めるのが現実的です。
最初は送信せず、仕分け結果だけを人と比べる
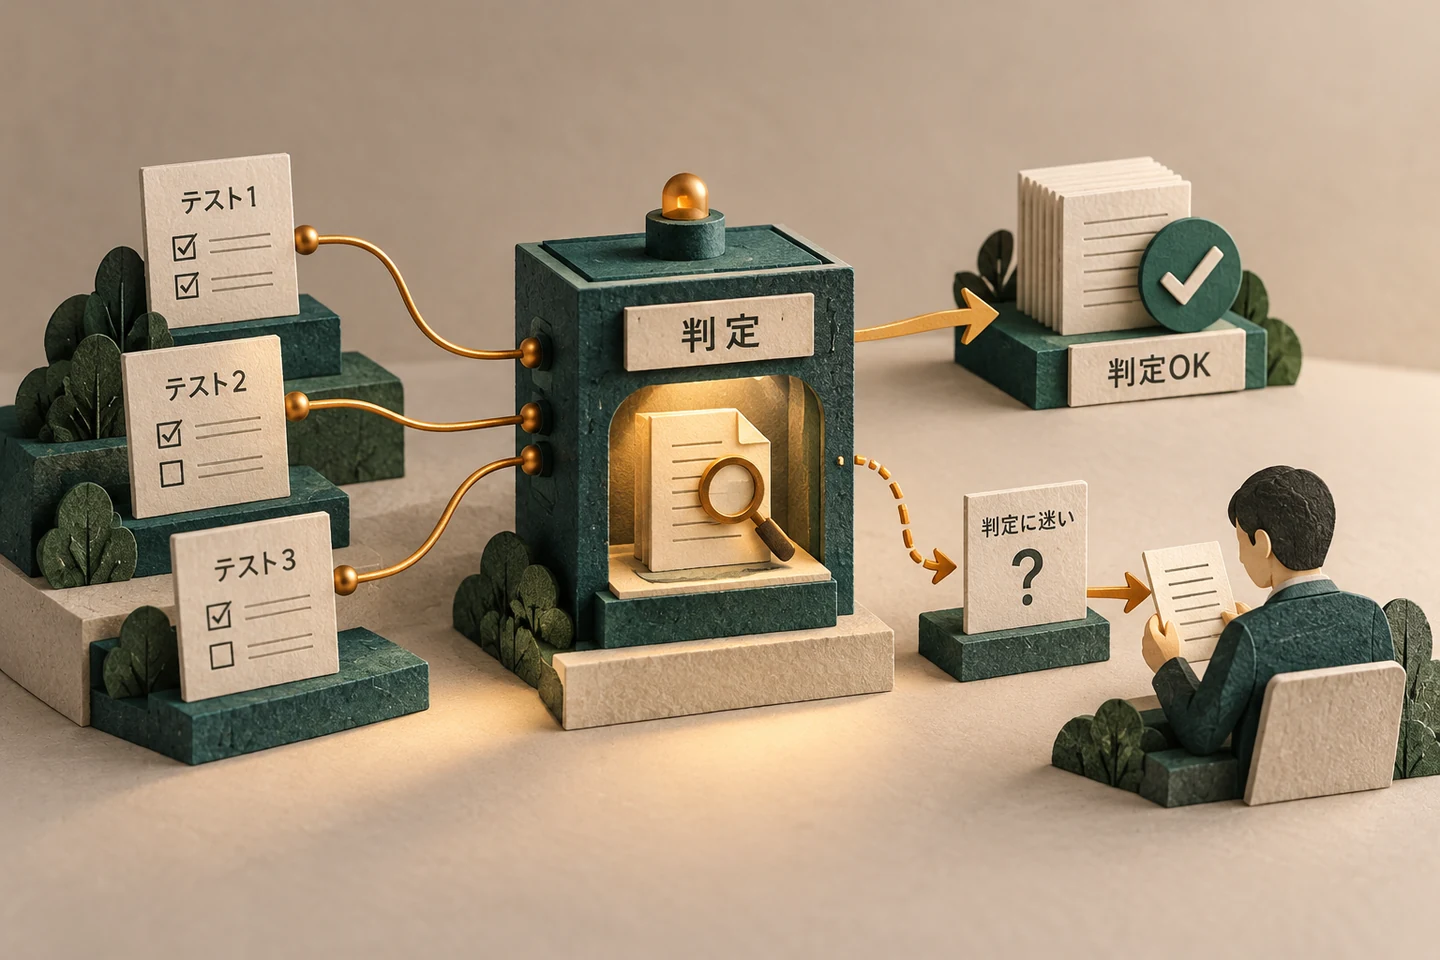
導入の第一歩は、モデル選びより「何を判断させるか」を一つに絞ることです。おすすめは、問い合わせの分類や告知の不足項目チェック。返金や外部送信など、結果がそのまま重大な操作につながるものから始める必要はありません。
- 「定型案内・個別相談・人の確認・情報不足」のように、答えの候補を決める。
- 個人情報を除いた例を用意し、人が期待する分類を付ける。
- AIは分類だけを返し、送信・公開は行わない状態で試す。
- 普通の例、紛らわしい例、必要情報が欠ける例で誤りを調べる。
- 品質が足りた範囲だけに広げ、迷った結果や通信失敗は人へ戻す。
試作では、たとえば20〜50件から癖を見つけられます。ただし、これは作業を始めるための目安で、安全性を証明する件数ではありません。正答率だけでなく、人に渡すべき苦情を定型案内にしてしまう見逃しも別に数えます。
OpenAIの評価ガイドも、実際の用途に合わせたデータと、人の判断との照合を重視しています。評価に使った例だけに合わせず、新しい例でも確かめることが必要です。OpenAI公式:Evaluation best practices
Codexへ依頼するなら、次のように対象と完成条件を伝えると具体的です。
問い合わせの仕分けを試作してください。
答えは「定型案内・個別相談・人の確認・情報不足」です。
まず通常コードで確認できる項目を処理し、
文章の意味の判断だけ、利用可能なモデルへ渡してください。
候補外の結果、通信失敗、迷う結果は人の確認へ戻してください。
個人情報を含まない評価例で、人の分類と比較してください。
今回は分類結果の表示まで。返信の送信は行わないでください。
処理時間、誤分類、見逃し、費用を記録し、
既存LLMで十分か、Jevを試す価値があるか判断できる形にしてください。
なお、CodexのAuto-reviewが、作ったアプリへ自動で移植されることはありません。APIやAgents SDKで作る仕組みには、必要なチェックと承認を別途組みます。OpenAI公式:Guardrails and human review
よくある疑問
「YES/NOだけなら間違えませんか?」
答えが二つでも、判断は間違えます。情報不足を受け止める第三の経路が必要です。
「指示を一文入れれば、自動で別モデルへ切り替わりますか?」
その一文は実装依頼の入口です。自動切替には、実際に呼べるモデルと接続、振り分けコード、評価が必要です。
「Jevは解約してよいですか?」
先に同じ仕事で比較しましょう。この記事では、接続設定・契約・既存のJev運用は変更していません。
今日の仕事で、何度も繰り返している判断を一つ書き出してみてください。「この問い合わせは誰が対応するか」だけでも十分です。自動化の相談は、AI相談の相談・講座案内からどうぞ。
まず仕分ける。迷ったら人へ戻す。 小さな判断から整えると、考えるべき仕事に時間を残せます。